2025 年 12 月,OWASP 发布 2026 版 Agentic Applications Top 10[1],列出智能体应用的十类主要威胁,下面的推导以它为参照。
第 1 篇把 agent 运行时拆成六层与两个部件,并留下两条结构性事实:结构性事实 1 是所有外部内容在组装时汇成一条没有来源标记的平坦 token 流;结构性事实 2 是判定检查点只覆盖“模型 → 动作”这一段,内容进入与配置加载都不经过它。沿着这张结构图推导,得到的攻击面与威胁清单不同:它的意义在于可检验,任何一个新漏洞、新技术出现,都能定位它落在哪个攻击面上;定位不上,则暴露的是结构图的缺口,两种结果都推进认识。推导完成后,把上一节 OWASP 给出的十类威胁逐条放回七个攻击面,威胁清单与结构图的对应关系也就清楚了。
推导按三个问题展开:agent 的行为由哪些状态决定,执行由哪些关卡拦截;这些状态与关卡推出哪几个攻击面,各落在架构图的什么位置;一个攻击面要变成一次实际攻击,中间还差什么。
OWASP 2026 版 Agentic Applications Top 10
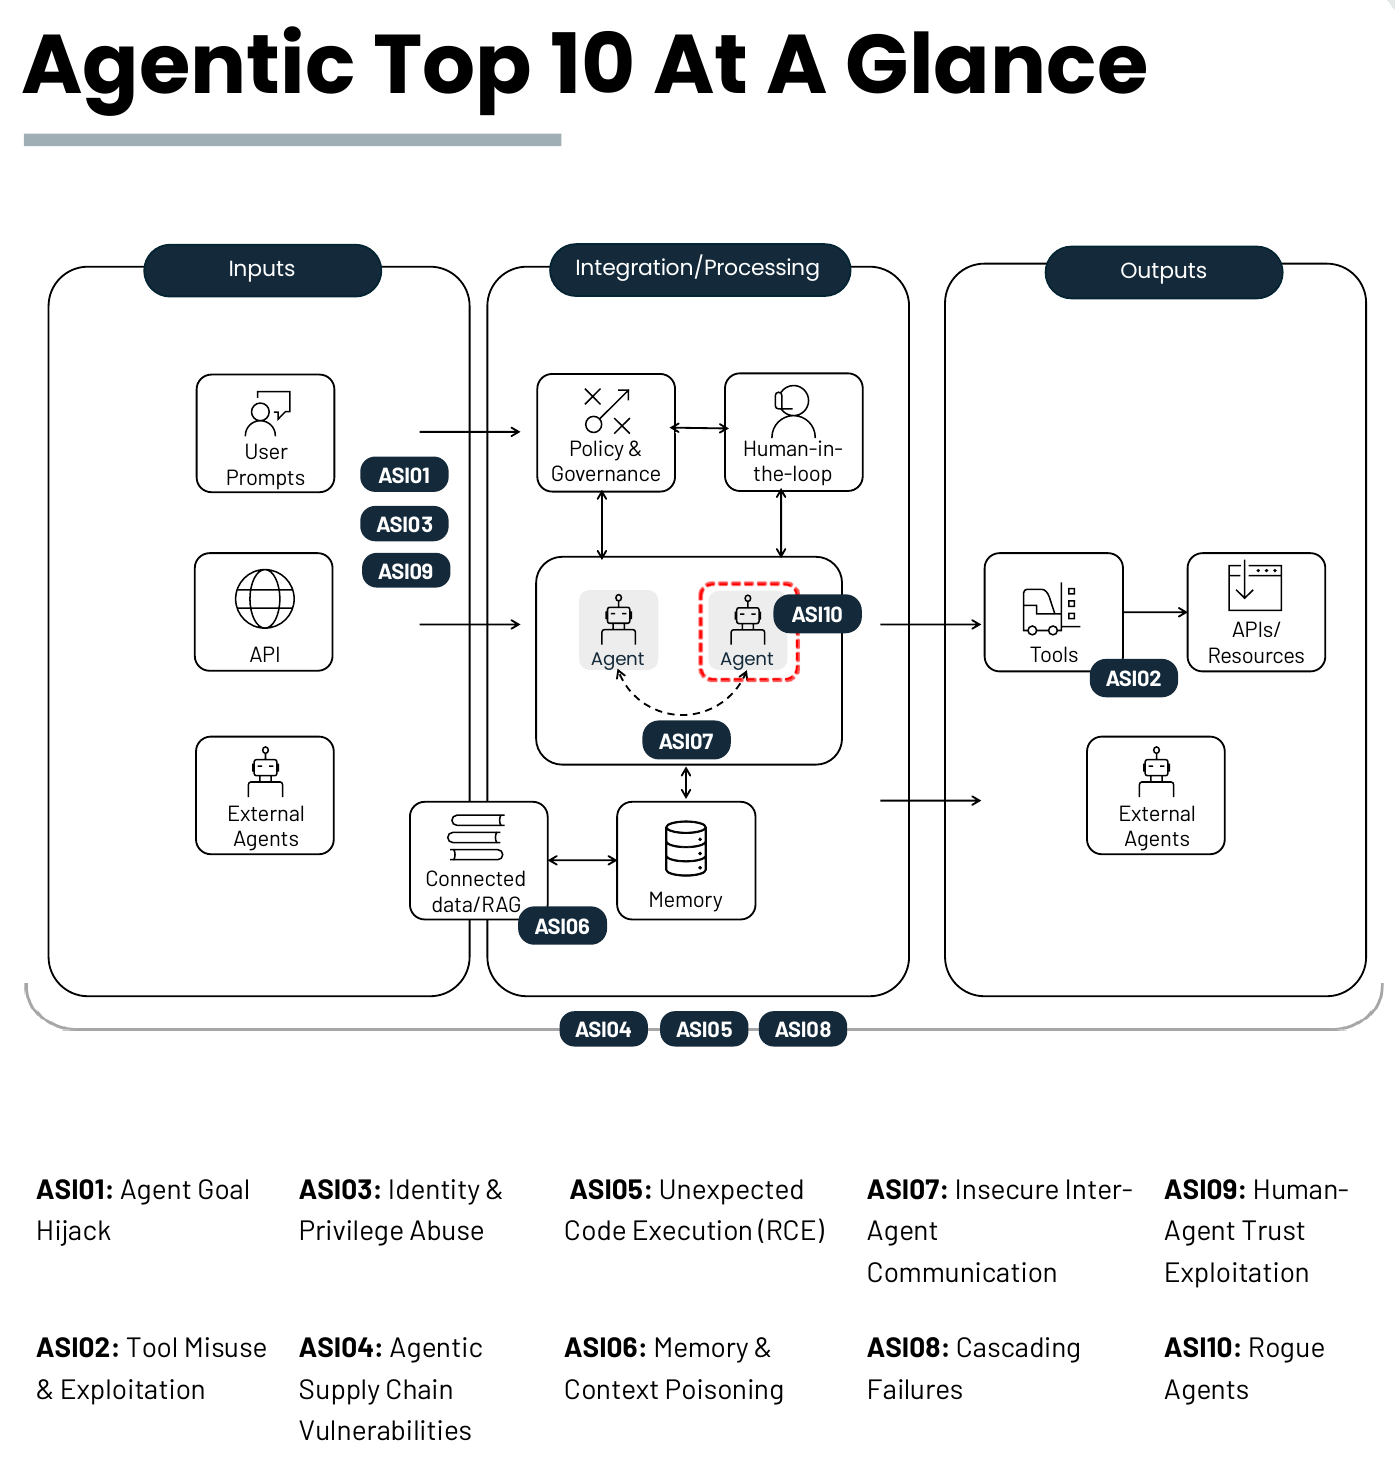
图源:OWASP Top 10 for Agentic Applications(2026)[1]。十类如下:
- 目标劫持(ASI01):利用模型无法可靠区分指令与内容的固有弱点,操纵 agent 的目标、任务选择与决策路径,影响覆盖后续多步行为而非单次回答;
- 工具滥用与利用(ASI02):agent 在授权范围内以不安全或非预期的方式使用合法工具,如删除数据、过度调用付费接口、外传信息;涉及提权归 ASI03,形成代码执行的归 ASI05;
- 身份与权限滥用(ASI03):操纵委托链、角色继承与 agent 上下文实现提权;根源是身份体系以人为中心,agent 没有独立受治理的身份,最小权限无法真正执行;
- 智能体供应链(ASI04):模型、工具、插件、数据集、MCP 与 A2A 接口、注册表、更新通道等第三方组件被投毒或篡改;与传统软件供应链的差别在组件多为运行时动态装配;
- 意外代码执行(ASI05):注入、工具滥用或不安全序列化把文本变成可执行行为,后果是宿主或容器接管、驻留与沙箱逃逸;代码常由 agent 实时生成,绕过基于静态规则的安全管控;
- 记忆与上下文投毒(ASI06):对话历史、长期记忆、检索库被写入恶意或误导数据,污染此后的推理、规划与工具选择,跨会话传播;这一类投毒针对存储的上下文,当次输入的注入归 ASI01;
- 不安全的智能体间通信(ASI07):多智能体系统的消息交换缺乏认证、完整性与语义校验,可被拦截、伪造与篡改,威胁横跨传输、路由、发现与语义各层;
- 级联失败(ASI08):单一缺陷沿智能体网络传播放大成系统性故障;它描述扩散本身而非起点,起点按性质归 ASI04、ASI06 或 ASI07;
- 人机信任利用(ASI09):利用拟人化信任、权威偏差与自动化偏差,让人不加验证地批准 agent 的输出与建议,审批链上的人成为被利用的一环;
- 失控智能体(ASI10):恶意或被攻陷的 agent 偏离预期功能与授权范围,行为漂移且伪装合规;清单关注漂移开始后的行为完整性丧失,不是初始入侵。
这份清单完成了自己的任务:给做 agent 安全的人当参考,收录影响最大的十类威胁,公开攻击的主要形态都在其中。它的组织方式是威胁类型,不是 agent 内部结构,所以回答不了这样的问题:每一类威胁落在运行时的哪个位置、哪几类威胁共享同一个根因、为什么公开漏洞集中在其中几类而其余几乎为零;回答这些问题,需要的是从结构出发的推导。
推导方法:从架构图到攻击面
推导从第 1 篇的架构图出发:
一个 agent 运行时里,行为由五类状态决定,每一类都对应架构图上的一个确定位置:
| 状态 | 在架构图上的位置 | 被写中意味着 |
|---|---|---|
| 上下文内容 | L2 每一轮组装出的请求,模型据此决策 | 模型按攻击者的指令决策 |
| 判定规则 | L4 判定的输入,由配置面下发 | 攻击者把自己要执行的动作写成免确认 |
| 组件构成 | L5 注册的工具与 MCP server | agent 多出一条攻击者定义的数据通路 |
| 持久状态 | L6 的记忆、会话记录与凭证 | 影响延伸到之后的每一次会话 |
| 呈现信息 | L1 展示给用户、供审批的内容 | 用户看到的是攻击者构造的画面 |
五类状态有一条共同性质:只要不可信输入能写中其中一类,agent 的行为就被控制了。
执行由四道关卡拦截:
| 关卡 | 机制形态 | 失效方式 |
|---|---|---|
| 判定与审查 | L4 的逐动作检查,有确定性规则与模型自动审查两种形态 | 规则被词法绕过、被改写、被整段跳过;模型审查有信息盲区 |
| 沙箱 | 执行全程持续的边界 | 覆盖有缺口、边界可逃逸 |
| 框架与运行时自身代码 | 承载各层的实现:序列化、解析、进程间通信 | 自身实现缺陷可被直接利用,不经模型与判定 |
| 人 | 最后一道审批 | 审批疲劳下机械放行、被伪造的呈现欺骗 |
攻击面由两部分组成。第一部分是可写入的位置:上表中的每一类状态都有自己的到达路径,不可信输入沿这些路径写入。第二部分是可绕过的关卡:每道关卡都有自己的失效方式,判定可被绕过、沙箱可被击穿、框架代码可被直接利用,失效一旦成立,没有下一道防线再拦。
两部分要组合起来才构成实际攻击,单独任何一半都不成立。只写不绕,写进来的东西没有人替它执行;只绕不写,关卡放行的仍是正常动作,行为没有被控制。实际攻击几乎总是两步的组合:先写中某个状态改变行为,再从某个关卡的缺口过去。
三个公开案例各占一种组合:
- 经典注入:内容写中上下文,同时判定对白名单内的动作免确认,被劫持的决策不经检查直接执行;
- 配置即执行:组件构成被写中,事件钩子触发执行,全程不经模型与判定(结构性事实 2);
- Cursor 的 DuneSlide:注入操纵模型填写的参数,沙箱按被操纵的参数构建写入白名单,最终覆写沙箱执行器本身[2]。
推导的范围先划一条边界:攻击面只覆盖攻击者经不可信输入触达的失效。三类常见的失效因此排除在外。
- 幻觉与超出授权的自作主张,出在 agent 自身,背后没有攻击者。
- 资源耗尽,它可以是攻击的结果,但不是一条独立的路径。
- 用户本人直接注入的指令,用户是授权主体,自己给的指令不构成攻击。
有一种情况容易误判:用户把第三方内容转贴进对话,这些内容的来源不是用户,仍然按不可信内容处理。
七个攻击面
推导方法里的两张表各推出一部分攻击面,五类状态推出上下文、配置、持久状态、呈现四个可写入的攻击面。判定规则与组件构成都由配置文件承载,在这里合并成一个配置攻击面;四道关卡里,判定、沙箱、框架自身代码推出三个可绕过的攻击面。第四道关卡是人,攻击人的方式是写呈现与骗审批,这两种方式都落在人机接口攻击面上,人因此不单独构成攻击面。四个可写入的攻击面加三个可绕过的攻击面,就是七个攻击面。标到 Agent 结构图上,S1 至 S7 即正文的攻击面 1 至攻击面 7:
攻击面 1:上下文注入(S1,L2→L3,可写入)。 任务输入、工具定义与返回、读入的文件与网页、跨会话存续的记忆,这些内容在 L2 组装时汇成同一条无来源标记的 token 流(结构性事实 1),写入这个攻击面的直接对象是模型的决策。注入载体覆盖最普通的日常内容:网页、issue 评论、工具描述、仓库里的注释,攻击者不需要任何特殊入口。注入本身是投递而非漏洞:模型被劫持后能走多远,由攻击面 3 与攻击面 4 决定,这一关系决定了注入类攻击的完整形态总是一条链。
攻击面 2:配置(S2,CFG,可写入)。 配置文件承载判定规则、组件注册、事件钩子与运行参数四类内容,写入配置等于不经模型、不经判定地更改机器。到达路径落在第 1 篇所述信任梯度的低端:项目目录里的配置随仓库克隆一并进入,市场自动安装由 agent 自己完成,两者都是攻击者可以安排的写入方式。从公开 CVE 的数量看,这是目前产出最多的攻击面。
攻击面 3:判定绕过(S3,L4,可绕过)。 判定机制自身有四类失效方式。
- 词法绕过:命令文本到效果分类的映射对不上语义,判定器读到的与实际执行的是两回事。
- 规则被改写:经攻击面 2 的通道写入白名单,或诱导用户批准范围过宽的规则。
- 路径被跳过:事件钩子的执行不经过判定。
- 审查盲区:模型审查看不到密文与执行语义中携带的恶意意图。
攻击面 4:沙箱(S4,执行边界,可绕过)。 沙箱的失效分四类。
- 覆盖缺口:profile 通常只约束写与执行,读操作不设限,凭证处于可读状态。
- 越界执行:用户批准越界动作后,这一次执行退出沙箱、在宿主机上直接运行,整条边界随之失效。
- 边界逃逸:沙箱内的代码突破边界本身,重新拿到宿主机的完整权限。
- 构建依赖模型参数:沙箱按模型填写的参数构建白名单,参数被注入操纵时边界随之失守,DuneSlide 已经把这条路径完整走了一遍[2]。
攻击面 5:持久状态(S5,L6,可写入)。 记忆与会话记录被写入之后,本次会话的出口成为后续会话的入口,单会话攻击由此变成持续存在,驻留与远控都落在攻击面 5 上。凭证的暴露面由读路径与通信出口两部分构成,两者同时可达,变现才成立。从公开记录看,这是事件与研究落差最大的一个攻击面。
攻击面 6:人机接口(S6,L1,可写入)。 四道关卡里最后一道是人,攻击人靠控制人看到的内容,而内容全部经 L1 呈现,这个攻击面因此落在 L1。呈现是可写入的目标,从数据到屏幕的显示过程独立于模型决策:AutoGPT 的 CVE-2023-37275 中,恶意网页携带的 ANSI 转义序列不经过模型,直接被终端渲染成伪造的命令输出,被欺骗的是查看屏幕的人[3]。审批环节同样可以被欺骗,具体形式包括审批疲劳下的机械放行、伪装成正常流程的同意请求,以及不显示真实执行内容的界面。
攻击面 7:框架与运行时(S7,harness 自身代码,可绕过)。 这个攻击面指向 harness 自身代码的实现缺陷,范围包括 L2 与 L5 的序列化、checkpoint、解析器、本地服务,以及 V8、Electron 一类原生运行时的自身漏洞,失效形态有状态投毒、解析混淆与可信文件被覆写。由于攻击对象就是包裹模型的代码本身,这类缺陷不需要经过模型与判定,Langflow 的未认证远程代码执行(CVE-2025-3248)是典型:浏览器一次访问就触发。
七个攻击面合起来看,排布有一条清晰的逻辑:攻击面 1 与攻击面 2 改变行为,前者操纵模型决策,后者更改机器;攻击面 3 与攻击面 4 绕过关卡,对应判定与沙箱;攻击面 5 让攻击跨会话持续存在;攻击面 6 与攻击面 7 针对最后的兜底环节,即人与代码。没有一个攻击面以模型为攻击对象。第 1 篇末尾还只是观察,推导完成之后成了结论:所有关卡都落在 harness 上,模型不在关卡序列里,模型被攻破只提高攻击面 1 的写入成功率,不构成独立的攻击面。
| # | 攻击面 | 架构位置 | 性质 | 公开案例(节选) |
|---|---|---|---|---|
| 1 | 上下文注入 | L2→L3 | 可写入 | EchoLeak(CVE-2025-32711) |
| 2 | 配置 | CFG | 可写入 | Claude Code 59536 / 21852、Codex 61260、Copilot 53773 |
| 3 | 判定绕过 | L4 | 可绕过 | Browser Use 47241 |
| 4 | 沙箱 | 执行边界 | 可绕过 | DuneSlide、ChatMate(CVE-2026-32193) |
| 5 | 持久状态 | L6 | 可写入 | 记忆投毒事件 15 起以上 |
| 6 | 人机接口 | L1 | 可写入 | AutoGPT 37275 |
| 7 | 框架与运行时 | harness 自身代码 | 可绕过 | Langflow 3248、LangGrinch 68664 |
把上一节 OWASP 给出的十类威胁逐条放到七个攻击面上,对应关系如下图:
十类的归属分成清晰的三组:
- 第一组归属单一:ASI01 目标劫持落在攻击面 1,ASI03 身份与权限滥用与 ASI06 记忆与上下文投毒落在攻击面 5,ASI09 人机信任利用落在攻击面 6。
- 第二组横跨两处:ASI02 工具滥用同时触及攻击面 1 与攻击面 2,ASI04 供应链落在攻击面 2 并延伸到环境侧,ASI05 意外代码执行覆盖攻击面 2 与攻击面 7。
- 第三组不落在任何位置:ASI07 与 ASI08 描述失效沿通道扩散的形态,是路径属性而不是新的位置;ASI10 是 agent 作为攻击方的反向维度,在攻击面体系之外。
值得注意的是,攻击面 3 与攻击面 4 没有任何条目直接对应,判定与沙箱两类关卡失效在清单里被合并进了工具滥用与意外代码执行,攻击面体系把它们单独立了出来。
从攻击面到攻击路径
攻击面给出的是可以写入的位置,位置要变成实际危害,还差一条从入口走到出口的路线,这条路线就是攻击路径。完整的攻击路径分为五段,每一段的取值都在固定的选项集合之内:
| 路径段 | 选项集合 |
|---|---|
| 通道(怎么进来) | 内容 / 服务 / 文件 / 内部(跨会话记忆、子 agent 消息) |
| 写入(落在哪个攻击面) | 攻击面 1 上下文 / 攻击面 2 配置 / 攻击面 5 状态 / 攻击面 6 呈现 |
| 绕过(哪道关卡放行) | 攻击面 3 判定 / 攻击面 4 沙箱 / 攻击面 7 框架代码 / 人 |
| 效果 | 读 / 写 / 执行 / 通信 |
| 出口 | 变现 / 驻留 / 扩张 |
一次完整的攻击路径,就是把五个段各填一个值。用配置即执行这条链走一遍:通道是文件,恶意配置随仓库克隆进入;写入落在攻击面 2 配置;绕过利用的是事件钩子不经判定的缺口;效果是执行;出口是驻留,写下的钩子在之后的每次会话里继续生效。
七条典型路径的来源就在这张表里。写入段的选项是四个可写入的攻击面;绕过段的选项是四道关卡,判定、沙箱、框架代码对应攻击面 3、4、7,第四道关卡是人,人不是攻击面,骗过人的写入落在攻击面 6。
生成办法是让这七个攻击面轮流当答案,不做选项的穷举组合(那会有几百种无意义的组合):轮到哪一个,它就填进写入段或绕过段,通道、效果、出口三段填它最典型的取值,五段连起来就是一条路径。攻击面 1 当答案是:恶意内容从网页、issue 评论这类入口进来,写进上下文,劫持模型决策后专挑免确认的动作执行,连起来就是上下文注入链。七个攻击面各当一次答案,得到七条典型路径,表格每行只写固定填入的攻击面与标志性后果:
| 典型路径 | 攻击面 | 路径形态 |
|---|---|---|
| 上下文注入链 | 攻击面 1 | 把恶意内容写进上下文,劫持模型决策后专挑免确认动作执行 |
| 配置即执行链 | 攻击面 2 | 把规则与钩子写进配置,触发执行不经模型与判定 |
| 判定绕过链 | 攻击面 3 | 构造特制输入让判定误判,读取敏感文件或执行命令 |
| 边界击穿链 | 攻击面 4 | 操纵沙箱构建参数或利用解析间隙,覆写执行器或逃出边界 |
| 状态投毒链 | 攻击面 5 | 把恶意数据写进记忆与会话记录,成为后续会话的入口 |
| 人机欺骗链 | 攻击面 6 | 把伪造的呈现写上屏幕,骗得批准后凭证随执行出去 |
| 框架接管链 | 攻击面 7 | 直接利用框架自身代码缺陷,不经模型与判定 |
七条链并不各自独立,判定绕过链就是一个例子:要让判定面对特制输入,得先把内容送进来,写入一段填的是上下文注入的成果。真实攻击更常见的是几条链串在一起,Cursor 的 CurXecute 零点击链就是四个环节的复合链:注入完成投递,被劫持的模型自动执行白名单内的动作,随后抓取环境中的凭证,最后以反弹 shell 驻留。四个环节单独拿出来,每一个都有各自的公开分析;真正构成威胁的,是把它们串起来的完整链。因此典型路径是可供复用的标准件,而不是封闭的分类:单条典型路径描述一种走法,真实攻击按需组合。
出口一段还有一层含义。驻留类出口写下的记忆、钩子、配置与计划任务会成为下一次会话的输入,图中红色虚线画的正是这条回路:本会话的出口接到下一次会话的通道,一次性攻击由此变成持续存在。会话之内另有小循环,工具结果拼回上下文供下一轮推理使用,注入攻击依靠它在多步里逐步放大。一个循环在会话之内,一个循环横跨会话,两者同时存在,是 agent 攻击难以防御的结构性原因。
第 3 至第 9 篇按上表的顺序逐条展开这七条路径,每条配公开案例。
小结
至此,开篇的两张图对上了:OWASP 十类逐一放进七个攻击面,没有一类需要新位置。推导同时给出贯穿全系列的结论:攻击面全部落在 harness 上,没有一个以模型为攻击对象,模型被写入只是攻击面 1 的成功率问题,不是独立的攻击目标。从攻击面到攻击路径,中间是五段结构(通道、写入、绕过、效果、出口),一条路径就是把五个段各填一个值,七个攻击面各生成一条典型路径,真实攻击是几条链的组合;这套结构是后面每篇分析路径共用的基础。
下一篇进入第一个攻击面:上下文注入。各种内容怎么汇成一条流、写进来能控制什么、为什么输入侧的每一个过滤方案都堵不住它。
References
[2] Cato AI Labs — DuneSlide: Two Critical RCE Vulnerabilities (CVE-2026-50548 / 50549):https://www.catonetworks.com/blog/duneslide-two-critical-rce-vulnerabilities/
[3] NVD — CVE-2023-37275 (AutoGPT):https://nvd.nist.gov/vuln/detail/CVE-2023-37275
[1] OWASP — Top 10 for Agentic Applications (2026):https://genai.owasp.org/